
네, 데이터가 숨겨진 사진은 흔히 탐지될 수 있지만, 탐지란 대개 무언가가 추가되었다는 것을 알아내는 것이지 그것이 무엇인지 읽는 것이 아닙니다. 찾아내는지는 세 가지에 달려 있습니다. 숨기는 데 쓴 방법, 누가 보는지, 그리고 어떤 도구를 가져오는지입니다. 갤러리를 넘겨 보는 사람에게는 그림이 보입니다. 자동 스캐너에는 통계가 보이며 오경보를 많이 냅니다. 포렌식 도구를 가진 훈련된 조사관은 파일이 그림 이상의 것을 담고 있다는 것을 대개 알아낼 수 있고, 그래도 암호 없이는 암호화된 내용을 읽을 수 없습니다.
이 안내서는 그 각각의 시선이 무엇을 볼 수 있는지, 이미지 200만 개를 스캔한 가장 잘 알려진 현장 연구가 무엇을 발견했는지, 그리고 깨끗한 스캔 결과가 표시된 결과만큼이나 적은 것을 증명하는 이유를 설명합니다.
탐지는 세 단계에서 일어납니다
볼 수 있는 사람을 구분하면 도움이 됩니다. 각자 보는 것이 다르기 때문입니다.
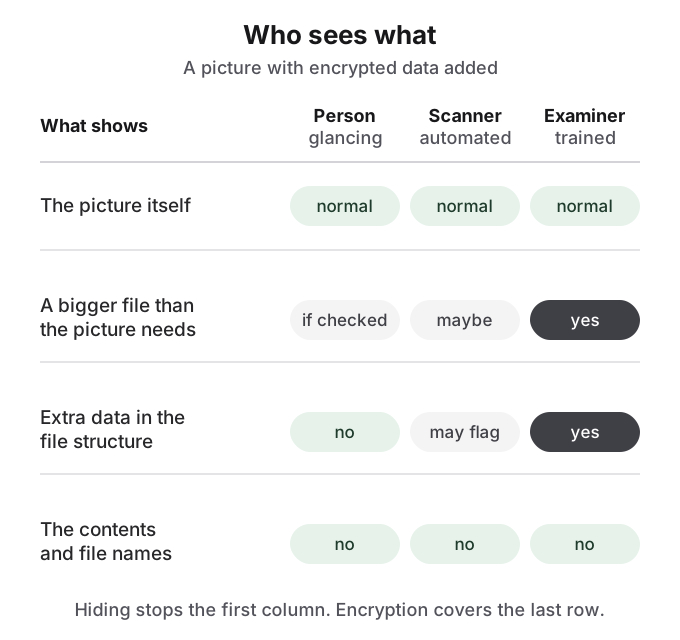
내 휴대폰이나 노트북을 흘끗 보는 사람은 썸네일을 봅니다. 어떤 종류의 스테가노그래피든 이 시선은 완전히 이깁니다. 그림이 똑같아 보이기 때문입니다. 알아챌 수 있는 단서는 크기뿐입니다. 파일 브라우저에서 수백 메가바이트를 차지하는 휴대폰 사진은 이상해 보입니다. r/privacy의 한 댓글 작성자는 사진이 "기적처럼 12GB의 데이터를 차지한다"는 말로 이 점을 짚었습니다.
자동 스캐너는 많은 파일에 통계 검정이나 형식 검사를 돌려 특이한 것을 표시합니다. 내용은 읽지 않으며, 놓치는 것과 오경보를 맞바꿉니다. 한 Hacker News 댓글 작성자의 말처럼 탐지기의 임계값은 "쓸모없어질 만큼 오탐을 많이 내지 않도록" 조정해야 합니다. "그리고 마법은 아닙니다."
훈련된 조사관은 시간과 전체 도구 모음을 갖고 기기나 파일을 하나씩 다룹니다. 파일에 이미지 이상의 데이터가 들어 있다는 것을 대개 알아낼 수 있습니다. 그것을 읽는 것은 별개의 문제이며, 강력한 암호화와 좋은 암호가 있으면 풀 수 없는 문제입니다.
통계적 스테간 분석은 흐트러진 노이즈를 찾습니다
진짜 스테가노그래피는 이미지 데이터 자체를 바꾸며, 가장 흔하게는 픽셀 값이나 JPEG 계수의 최하위 비트를 바꿉니다. 변화는 눈에 보이지 않지만, 자연스러운 사진은 그 비트에 특징적인 노이즈 패턴이 있고, 완전히 무작위처럼 보이는 암호화된 데이터는 이를 흐트러뜨립니다. Wikipedia의 요약으로 스테간 분석은 "일반적으로 통계 분석으로 처리"되며, 이상적으로는 의심 파일을 "같은 출처(예: 같은 모델의 디지털 카메라)"의 수정되지 않은 파일과 비교합니다.
연구의 역사는 경주입니다. 단순한 LSB 삽입에 대한 통계적 공격은 2000년과 2001년에 발표되었습니다. 단순한 통계를 보존하는 도구가 뒤따랐고, 고차 통계에 대한 공격이 그 뒤를 이었습니다. 예를 들어 OutGuess의 JPEG 방식은 2002년의 블록성 공격으로 깨졌습니다. 2012년 이후 최신 기술은 수천 개의 이미지 특징으로 훈련한 기계 학습 분류기입니다. 실무자들은 양 끝을 설명합니다. 한 Hacker News 댓글 작성자의 말로 단순한 LSB 치환은 "탐지하기 매우 쉽고", 다른 댓글 작성자는 "통계적으로 탐지할 수 없는 데이터 숨기기에 집중하는 방대한 연구"를 가리킵니다. 둘 다 사실입니다. 결정하는 것은 알고리즘과 숨긴 데이터의 양입니다.
한 경우는 너무 쉽습니다. 분석가에게 원본 사진이 있다면 두 파일을 비교해 어떤 변화든 즉시 드러납니다. 100개의 이미지를 "내 방법을 깨 보세요" 도전으로 올린 r/Steganography의 한 Reddit 사용자는 이를 금세 알게 되었습니다. 가장 많이 추천받은 답은 이미지가 나온 공개 데이터셋을 찾아내 비교했고, 파란색 채널의 LSB 변화를 발견했습니다.
파일 크기와 구조가 실용적인 숨기기 대부분을 드러냅니다
일상에서 쓰는 "사진 속에 파일 숨기기" 방법 대부분은 통계적인 것이 전혀 아닙니다. 이미지의 끝 표식 뒤에 데이터를 덧붙이거나, 파일 형식이 허용하는 추가 블록을 넣습니다. 스테가노그래피 원리가 각 방법을 자세히 설명합니다. 이런 접근은 훨씬 많은 데이터를 담고 그림을 픽셀 단위로 완벽하게 유지하지만, 분명한 구조적 단서를 남깁니다. 파일이 그 크기와 품질의 이미지가 가져야 할 크기보다 크고, 파일 전체를 읽는 프로그램은 이미지에 필요하지 않은 내용을 발견합니다.
어떤 의심 파일이든 일반적인 포렌식 작업 흐름은 이런 단순한 검사로 시작하며, 이국적인 통계로 시작하지 않습니다. r/computerforensics의 실무자들은 그 형식의 정상 파일이 어떻게 생겼는지 익히고, 파일의 시작과 끝을 확인하고, 읽을 수 있는 텍스트를 추출하고, 파일의 내부 구조를 나열하고, 서명으로 삽입된 파일을 도려내고, 엔트로피를 측정하는 것을 설명합니다. 암호화되거나 압축된 데이터는 거의 무작위로 점수가 매겨지기 때문입니다. 그런 다음에야 형식별 탐지기를 돌립니다. 덧붙인 데이터는 몇 초 만에 나타납니다. 암호화된 데이터는 읽을 수 없는 노이즈 덩어리로 나타납니다.
이미지 200만 개, 약 17,000개 표시, 메시지는 0개
실제 스테가노그래피를 측정하려는 가장 잘 알려진 시도는 Niels Provos와 Peter Honeyman의 2001년 연구입니다. 이들은 eBay 경매에서 이미지 200만 개를 내려받아 JPEG 탐지기 Stegdetect를 전부에 돌렸습니다. 약 17,000개, 대략 0.85퍼센트를 표시했습니다. 그런 다음 표시된 이미지에 분산 사전 공격을 돌렸고 아무것도 복구하지 못했습니다. "eBay 경매에서 내려받은 이미지 200만 개를 분석했지만 숨겨진 메시지를 단 하나도 찾지 못했습니다."
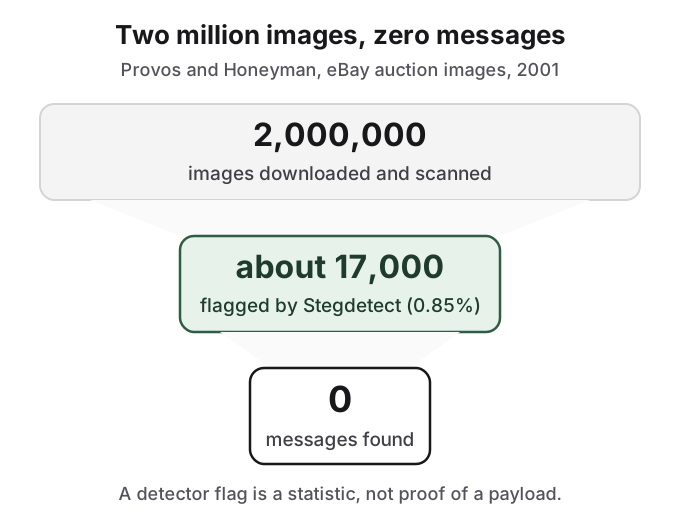
연구의 나이가 지나도 두 가지 교훈이 남습니다. 첫째, 표시는 값싸고 대부분 틀리며, 그래서 Wikipedia의 스테간 분석 문서는 탐지기 출력만으로 행동하는 것을 "페이로드를 완전히 복구하고 복호화하지 않았다면 매우 위험한 일"이라고 부릅니다. 둘째, 탐지와 복구는 다른 단계이며, 복구에는 암호가 필요합니다. 이 수치는 경매 사진에 대한 JPEG 도구의 2001년 스냅샷이지 현재의 탐지율이 아니며, 덧붙이거나 끼워 넣은 데이터에 대해서는 비견할 만한 최근 수치가 없습니다. r/computerforensics의 2012년 댓글 작성자는 비슷한 개인 프로젝트를 설명하면서 "수백만 개의 이미지를 스캔해서 약 200개를 찾았고" 그중 여섯 개를 무차별 대입했다고 했습니다.
깨끗한 스캔이 깨끗한 파일을 증명하지는 않습니다
탐지기도 놓칩니다. r/computerforensics에서 페이로드를 암호화하고 흩뿌리는 steghide로 만든 이미지에 여러 탐지기를 시험해 본 한 사용자는 이렇게 보고했습니다. "이 도구들 중 어느 것도 아무것도 찾지 못했습니다." Stegdetect 자체도 더 이상 개발되지 않습니다. 탐지되지 않았다는 것은 그 도구와 그 방법에 대한 진술이지, 아무것도 없다는 증거가 아닙니다.
같은 스레드는 누군가가 실제로 얼마나 자주 살펴보는지에 대한 유용한 현실 점검이기도 합니다. 그곳의 포렌식 실무자들은 이미지 스테가노그래피가 CTF 퍼즐에서는 흔하고 실제 수사에서는 드물다고 설명합니다. "CTF에서요? 많죠! 실제로는요? 생각만큼은 아니에요." 이것이 아무도 살펴보지 않을 것이라고 가정할 이유는 아닙니다. 숨기기만으로 버틸 것이라는 희망 위에 프라이버시 계획을 세우지 말아야 할 이유입니다.
내 휴대폰의 숨긴 사진에 이것이 뜻하는 바
종합하면 일상적인 사진 숨기기에 대한 솔직한 답은 이렇습니다. 내 기기를 쓰거나 빌리는 사람에게는 평범한 사진처럼 보이는 커버 파일이 통합니다. 그림만 보이고 다른 것은 보이지 않기 때문입니다. 목적에 맞게 만든 도구나 훈련된 조사관에게는 숨겨진 데이터가 알려질 것이라고 가정하고, 암호화와 강력한 암호로 내용을 비공개로 유지하세요. 그 암호를 내놓도록 법적으로 강제할 수 있는 사람에게는 숨기기도 암호화도 방어가 되지 못하며, 가지고 다니는 데이터를 줄이는 것만이 안전한 조언입니다.
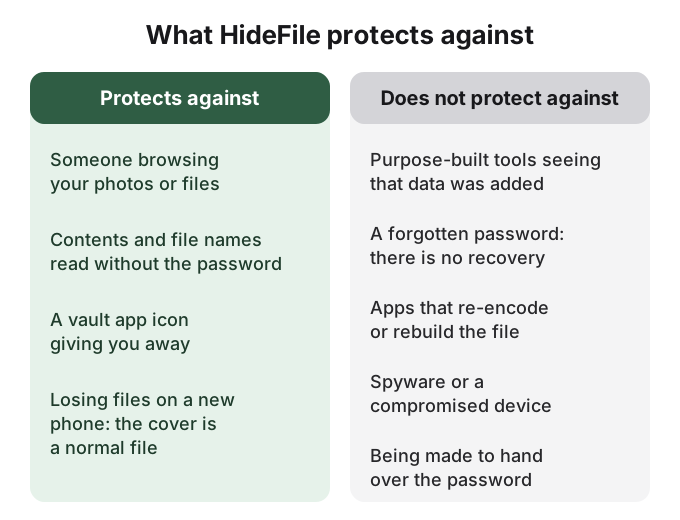
HideFile이 도움이 되는 부분
HideFile은 최신 브라우저의 hidefile.app에서 개인 사진과 파일을 평범한 사진, 비디오, PDF 안에 넣고 브라우저에서 내 암호로 암호화합니다. 파일은 HideFile 서버로 업로드되지 않습니다. 커버는 사진 앱, 비디오 플레이어, PDF 리더에서 일반 파일로 열리므로, 내 갤러리를 흘끗 보는 사람은 예상한 것을 봅니다.
이 페이지가 바로 그 한계에 관한 것이므로 분명히 밝힙니다. HideFile은 가벼운 훔쳐보기를 막아 주며, 포렌식 도구를 막아 주지는 않습니다. 픽셀을 바꾸지도, 통계 검정을 속이려 하지도 않습니다. 목적에 맞게 만든 도구는 커버에 데이터가 추가되었다는 것을 알아볼 수 있으며, 내용은 암호화된 채로 암호 없이는 읽을 수 없습니다. 암호 복구는 없습니다. 사진을 다시 인코딩하는 앱은 숨겨진 부분을 지워 버릴 수 있으므로 커버는 파일로 보관하고 공유하세요. 국경 검색, 훈련된 조사관, 법적 압박에는 맞지 않는 도구입니다.
이 질문의 양쪽 도구는 스테가노그래피 도구 비교를, 더 단순한 요령과 각각이 무엇을 속이는지는 사진에 파일 숨기기를, 금고 앱의 비교는 사진 금고 앱은 안전할까를 참고하세요.
출처
- Provos and Honeyman, Detecting Steganographic Content on the Internet, CITI Technical Report 01-11, 2001 (2026-10-14 확인)
- Wikipedia: Steganalysis 및 Steganography (2026-10-14 확인)
- Wikipedia: OutGuess (2026-10-14 확인)
- Kodovsky, Fridrich and Holub, "Ensemble Classifiers for Steganalysis of Digital Media", IEEE TIFS, 2012, doi:10.1109/tifs.2011.2175919
- Fridrich, Goljan and Du, "Detecting LSB steganography in color and gray-scale images", IEEE Multimedia, 2001, doi:10.1109/93.959097
- Reddit, r/computerforensics: Is there any tool to identify steganography?
- Reddit, r/computerforensics: Hidden files in jpeg images?
- Reddit, r/computerforensics: Does digital steganography actually see use in the real world?
- Reddit, r/Steganography: Can you break my steganography method?
- Reddit, r/privacy: Steganography - How to Hide Data from the Feds
- Hacker News: comment on detector thresholds
- Hacker News: comment on naive LSB detection
- Hacker News: comment on statistically undetectable hiding